RSSからXまで、ニュース配信をAIエージェントに任せた——「考える」のはLLM、「確かめる」のはコード
米・中・台・日の11媒体を拾って、AIが調べて、コードが検証して、承認制でXへ流す。LLMに任せる所と、コードで縛る所を分けて作った
— @aliexp_store 2026年10月22日
@aliexp_store で、自作PC・ガジェットのニュースを配信するエージェントを作った。RSSで記事を集め、要約し、同じ話題をまとめ、調査エージェントが裏取りして投稿案を書き、検証を通ったものだけを承認制でXに配信する仕組みだ。
この記事はその設計の記録。結論は一つで、「LLMには考えさせる。ただし事実はコードで確かめる」。
💭 何を作ったか、なぜ作ったか
自作PCのニュースは、英語・簡体字・繁体字・日本語であちこちに散らばっている。メモリ価格の話ひとつ取っても、台湾の報道が早く、米国の媒体が詳しく、日本語では数日遅れて出る。人が毎日全部追うのは無理だ。
かといって、記事をAIに要約させて流すだけでは怖い。誤訳、数値の取り違え、転載記事を「公式発表」と誤認する、といった事故が普通に起きる。速さと正しさを両立させるには、AIの出力をそのまま信じない設計が要ると考えた。
🧭 全体像
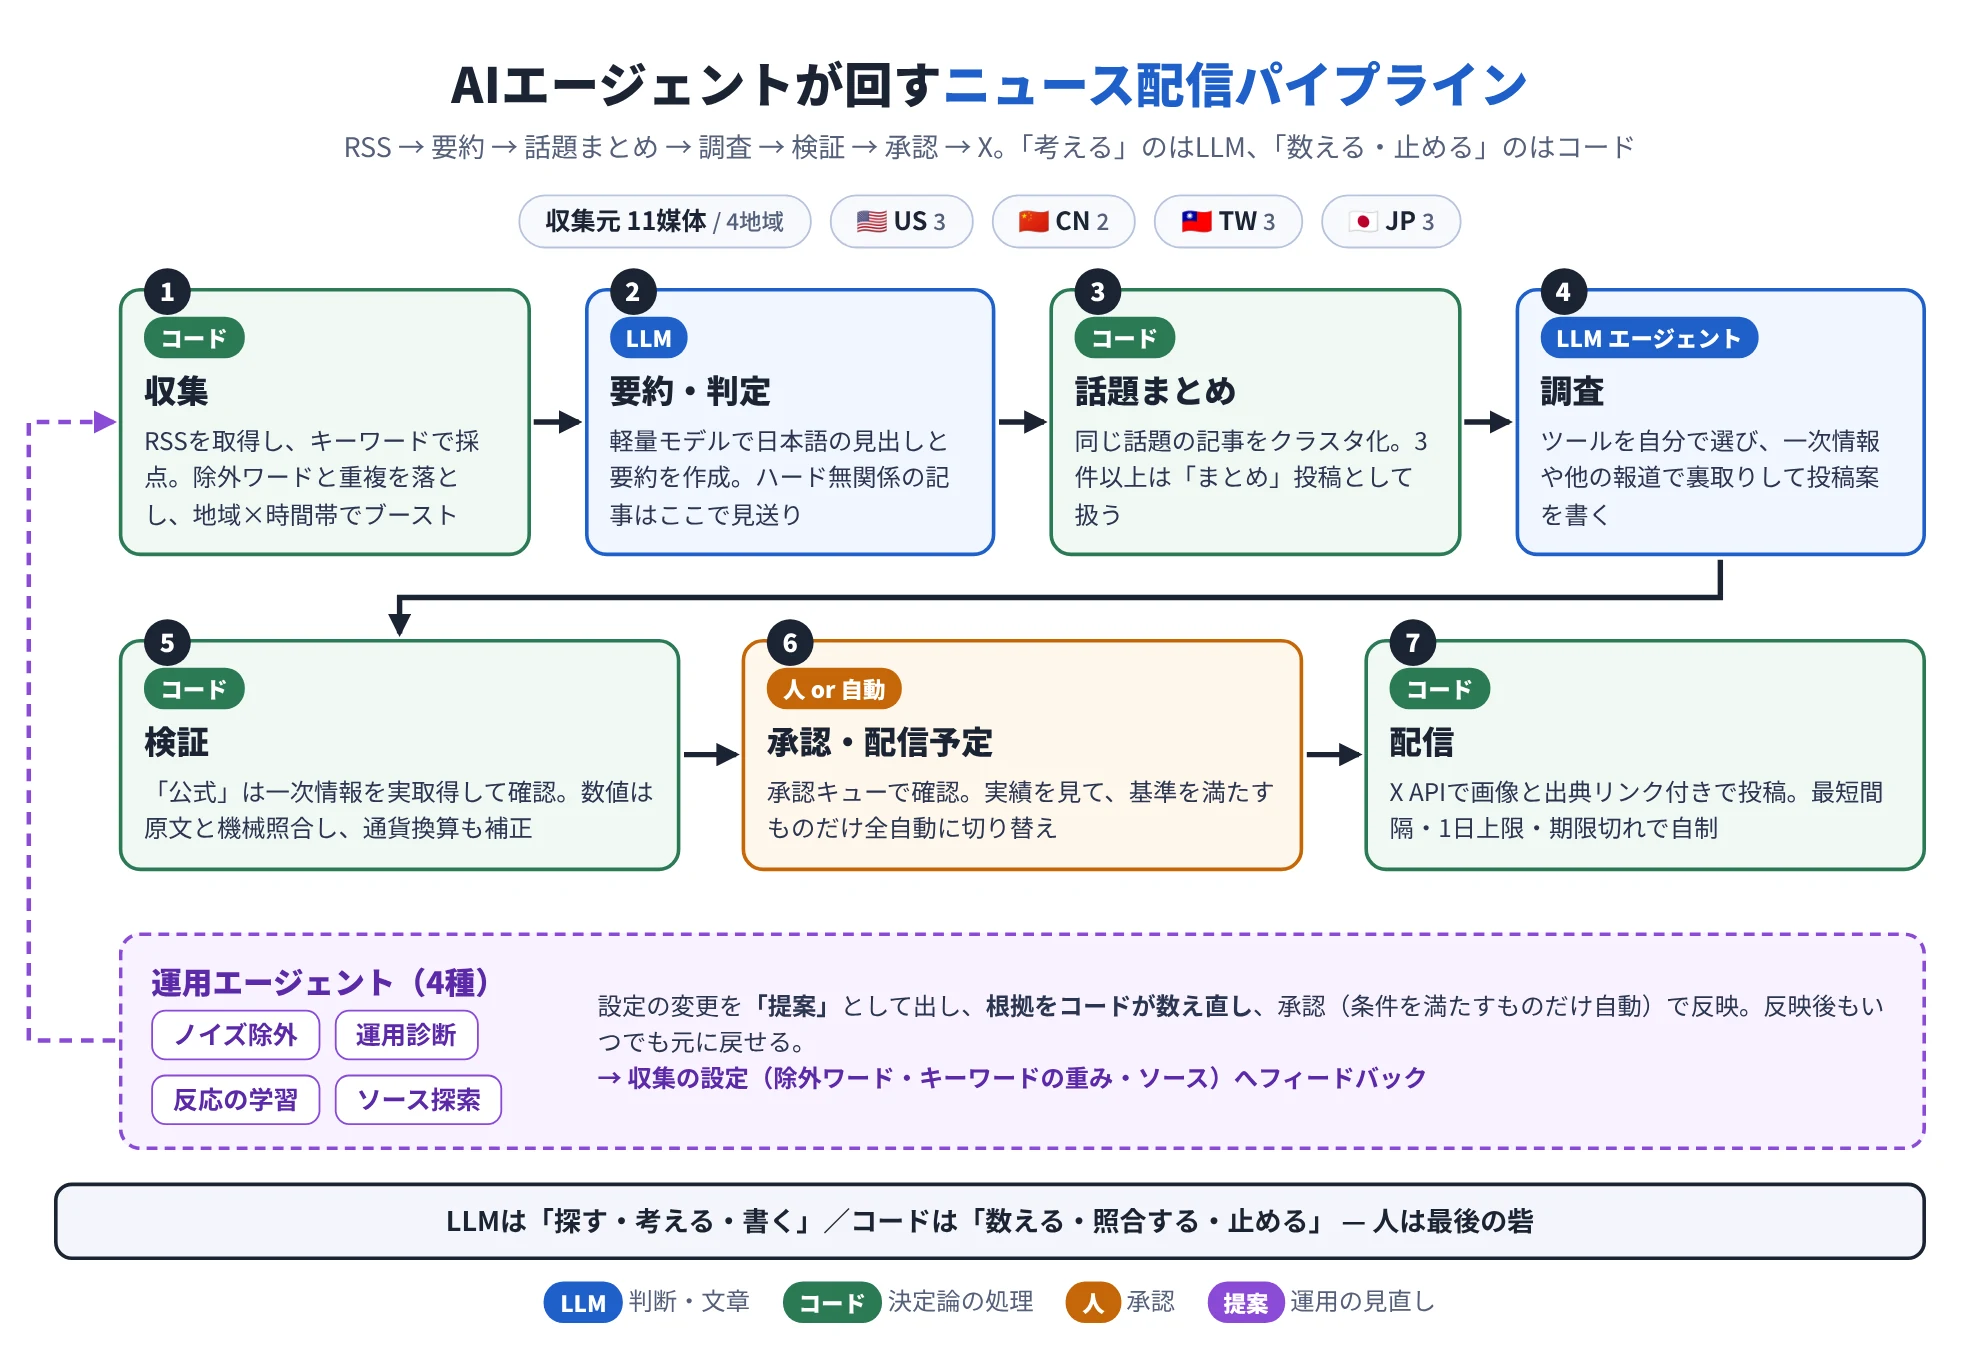
7つの段階を、LLMがやることとコードがやることにきっぱり分けている。
| 段階 | 担当 | やること | そう分けた理由 |
|---|---|---|---|
| ① 収集 | コード | RSS取得、キーワード採点、除外ワードと重複を落とす、地域×時間帯のブースト | 安くて決定論的。LLMを呼ぶ前に落とせば、トークンを使わずに済む |
| ② 要約・判定 | LLM(Haiku) | 日本語の見出しと要約を作る。ハード無関係の記事はここで見送る | 言語をまたぐ要約は、LLMの得意分野 |
| ③ 話題まとめ | コード | 同じ話題の記事をクラスタ化。3件以上報じていれば「まとめ」投稿にする | 「何件の媒体が報じたか」は数えるだけで決められる |
| ④ 調査 | LLMエージェント | ツールを使って一次情報や他の報道を確かめ、投稿案と確度を出す | 何を調べるかは話題ごとに違う。ここだけは判断が要る |
| ⑤ 検証 | コード | 公式判定・数値照合・通貨換算・出典URLの確認 | 事実に関わる所は、自己申告ではなく突き合わせで決める |
| ⑥ 承認 | 人/自動 | 承認キューで確認。実績を見て、基準を満たすものだけ全自動へ | 最初は人が見る。信頼は実績で上げる |
| ⑦ 配信 | コード | 画像と出典リンク付きでX APIへ投稿 | 投稿の安全装置は、コードでしか信用できない |
⏱️ 共有サーバーで回すための工夫
動いているのは、普通のレンタルサーバー(PHP+SQLite+cron)だ。常駐プロセスも、キューも、専用サーバーもない。この制約のおかげで、設計がだいぶ素直になった。
- ⏲️ cronで定期起動し、1回の実行は時間予算つき(収集は30分おき、配信は15分おき)。収集の1回で25秒だけ進め、残りは次回に回す。状態はSQLiteに持ち、「収集済み→要約済み→調査待ち→候補」と進んでいく状態機械にした
- 🔒 排他ロック。前の実行が終わっていなければ、次の実行は何もせず抜ける
- 🧯 失敗を隔離。運用エージェントは1つずつtry/catchで包み、1つが落ちても他と本体の配信は止めない
- 💰 日次のトークン上限(40万)を設け、超えたらLLMを止める。LLMなしでも動くようにフォールバックを用意してある(優先順位は規則で決める、ノイズ除外は提案止まり、など)
🕵️ 調査エージェント:ツールを自分で選ぶ
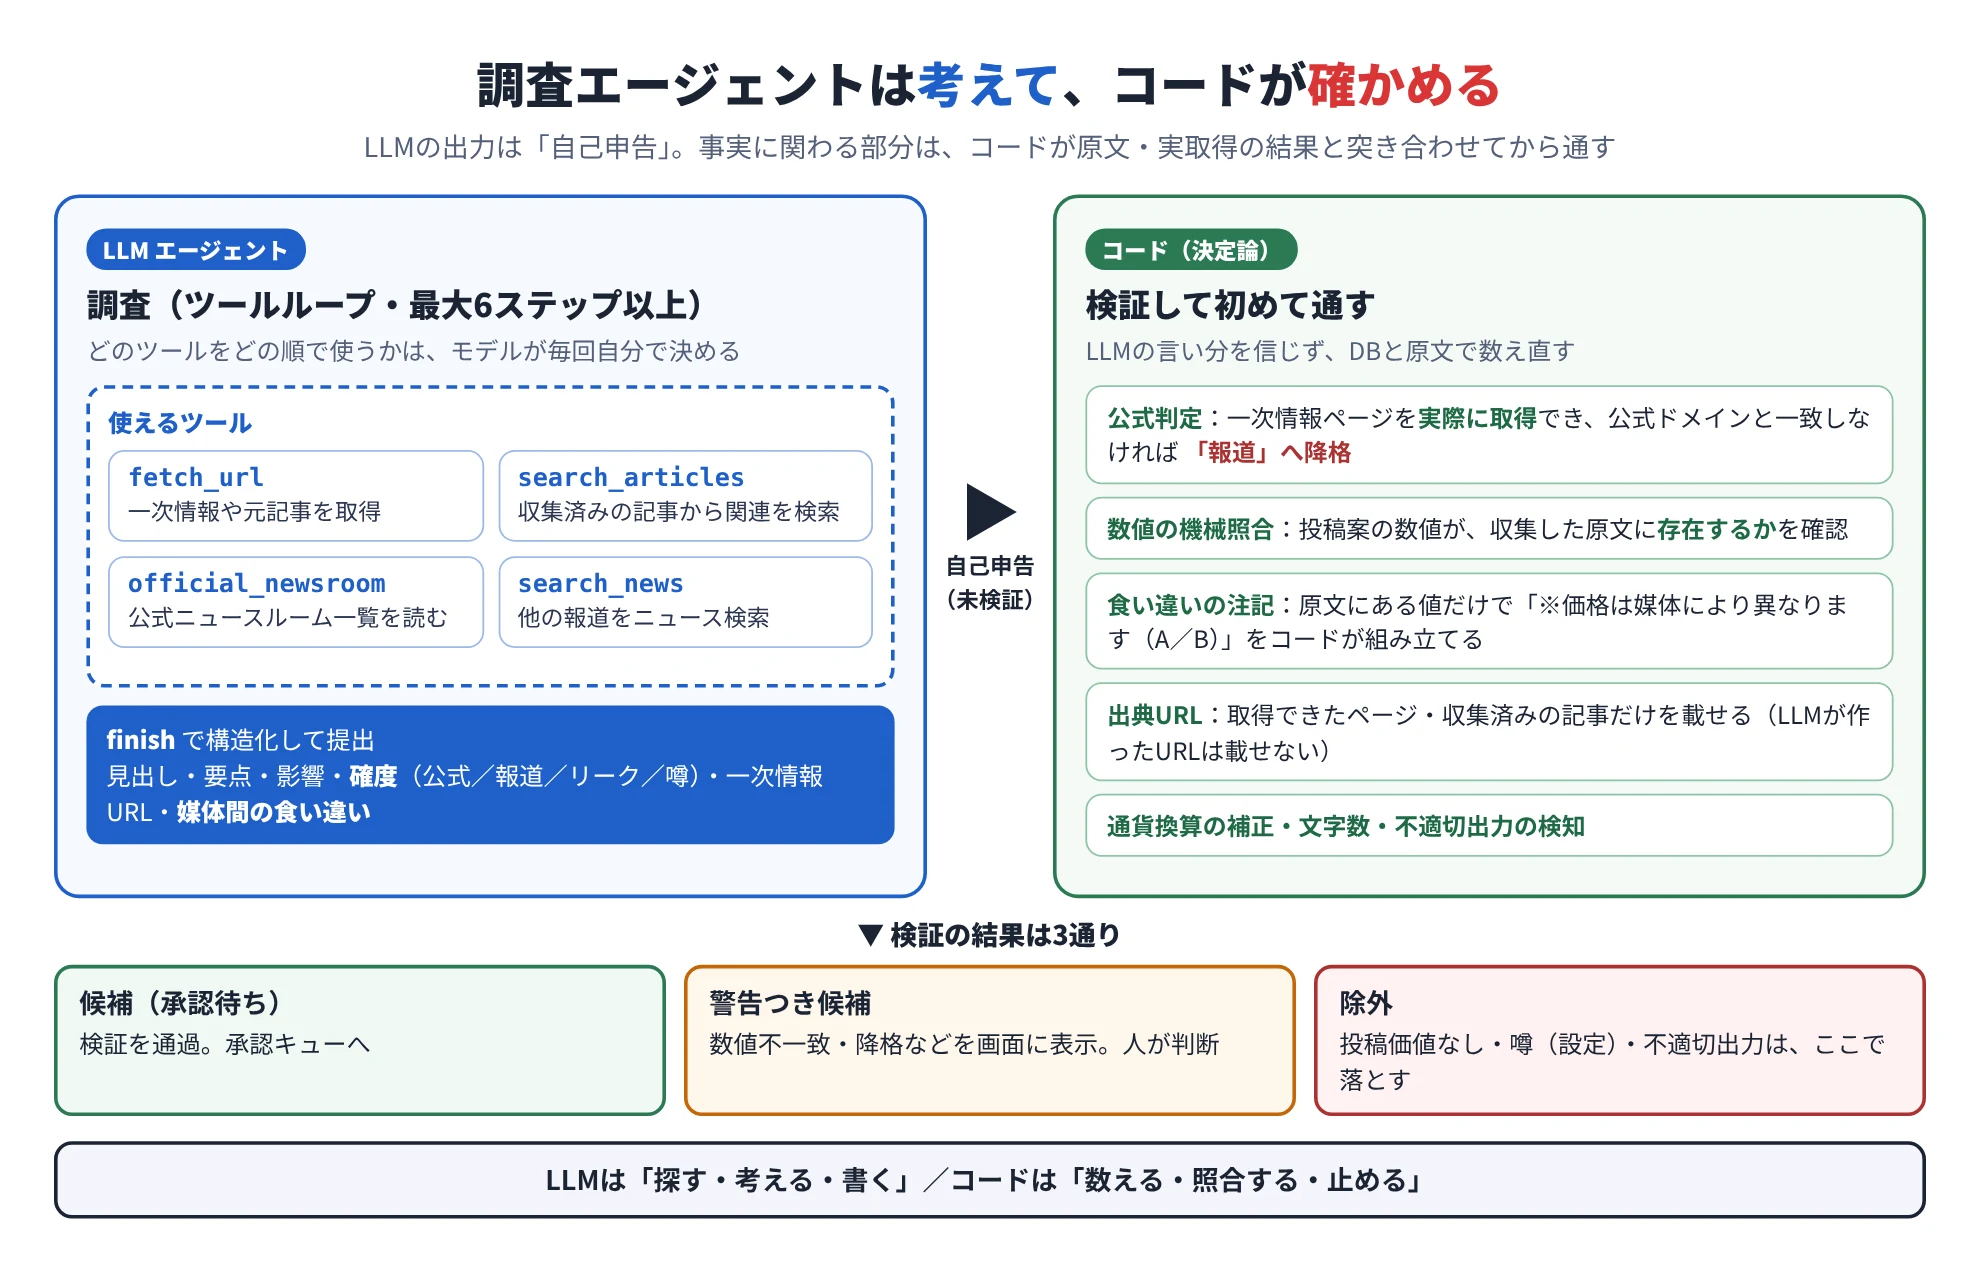
このシステムで本当にエージェントと呼べるのは、④の調査だけだ。他の段階は「LLMを1回呼ぶ」か「コードで処理する」にすぎない。
調査では、モデルに4つのツールを渡し、どれをどの順で使うかは毎回モデルに決めさせる。
| ツール | 何をするか |
|---|---|
fetch_url | 一次情報や元記事のページを取得する |
search_articles | 収集済みの記事から、関連するものを検索する |
official_newsroom | メーカーの公式ニュースルームの一覧を読む(NVIDIA、AMD、Intel、Micron、Samsung、SK hynix、TSMCなど) |
search_news | ニュース検索で、他の報道を探す |
調べ終わったら finish ツールで結果を提出させる。見出し、要点、影響、確度(公式/報道/リーク/噂)、一次情報のURL、媒体間で食い違っていた数値、を決まったスキーマで返させる。終わり方(出力の形)は固定し、途中の動きは任せる、というのがバランスの取り方だった。
✅ 検証はコードでやる:LLMの自己申告を信じない
調査エージェントが返すのは、あくまで自己申告だ。ここからコードが、突き合わせられるものを全部突き合わせる。
- 🏛️ 「公式発表」の判定:モデルが公式と言っても、一次情報のページを実際に取得でき、そのドメインが公式ドメインの一覧にあるときだけ公式として扱う。確認できなければ自動で「報道」に降格し、警告を付ける
- 🔢 数値の機械照合:投稿案に出てくる数値が、集めた原文のどこかに実在するかを確認する。見つからなければ警告
- ⚖️ 媒体間の食い違い:媒体によって価格や日付が違うとき、LLMには「どれが正しいか」を決めさせない。原文に実在する値だけを使い、「※価格は媒体により異なります(A/B)」の一文をコードが組み立てて注記する
- 🔗 出典URL:投稿に載せるのは、実際に取得できたページと、収集済みの記事のURLだけ。LLMが作ったURLや、Googleニュースのリダイレクトは載せない
- 💱 通貨換算の補正、文字数のチェック、拒否・不適切な出力の検知
結果は「候補」「警告つき候補」「除外」の3通りになる。警告つきの候補は、承認キューに警告つきで出るので、人が判断できる。
🧠 設定を見直す4つの運用エージェント
配信が回り始めると、設定の手直しが次々に必要になる。ノイズの多い語、役に立たないソース、反応の良いキーワード。これも人がやるのは面倒なので、4つの小さなエージェントに任せた。
| エージェント | 見ているもの | 出す提案 |
|---|---|---|
| 🧹 ノイズ除外 | 無関係と判定された記事・却下された話題に繰り返し出る語 | 除外ワードの追加 |
| 🩺 運用診断 | ソース別の歩留まり、却下が続く語、実行状況 | ソース停止、キーワードの重み変更・削除、しきい値の見直し |
| 📈 反応の学習 | 投稿後6時間・48時間のいいね・RT・返信などの反応 | キーワードの重みや地域ブーストの変更 |
| 🔭 ソース探索 | ニュース検索で見つかる未登録の媒体 | 新しいソースの追加(品質もLLMが評価) |
4つとも同じ枠組みで動く。提案 → 根拠をコードが数え直す → 承認 → 反映 → いつでも元に戻せる、という流れだ。
- 📋 提案できる種類と、数値の範囲を決めてある(たとえば重みの変更は一度に±2まで)
- 🔎 提案の根拠(「却下側に◯件・採用側に0件」など)は、LLMの言い分ではなく、コードがDBから数え直した値を使う。数え直して裏が取れなければ、提案ごと捨てる
- ♻️ 反映するときにもう一度検証し、反映前の値を保存して「元に戻す」を可能にする
- 🚫 却下した提案や、元に戻した語は、一定期間(2週間〜3か月)は再提案しない
唯一「条件付きで自動」にしているのが、ノイズ除外だ。LLMが選んだ語で、ノイズ側に4件以上・採用側に0件、12文字以内、メーカー名や部品名などの主要語ではなく、1日5語・合計40語の上限内——すべて満たしたときだけ自動で除外ワードに入る。外れたものは「承認待ち」に残る。
🚧 実際にハマったこと
① 初日に、運用診断が間違った提案を出した。
最初の本番実行で、運用診断が「DRAMキーワードの削除」と「2つの中国系ソースの無効化」を提案してきた。DRAMはこのアカウントの中心テーマの語だ。原因は、「取り込んだ記事が15件以上あるのに採用0件」というルールが、まだ要約も判定もしていない記事を数えていたことだった。立ち上げ直後は、ほとんどの記事が「未判定」なので、どのソースも採用0に見えてしまう。
直し方は、「判定済みの話題が10件以上溜まるまで診断しない」「ソース停止は判定済み10件以上で採用0のときだけ」「キーワード削除は拾った記事8件以上・却下5件以上・採用0のときだけ」と、根拠の最低ラインを決めること。承認制にしていたおかげで、誤った提案は反映前に気づけた。それでも、既存の承認待ちが反映ボタンで通らないよう、反映時にも再検証するようにした。データ不足は、悪い結果ではない、という学びだ。
② Googleニュースは入口であって、媒体ではない。
Googleニュース経由の記事は、リンクがリダイレクトURLで、媒体名も「Googleニュース」になる。これをそのまま出典に使うと、リンクも「参考」の欄も不自然になる。代表記事のURLにはリダイレクトを選ばず、媒体名は記事タイトル末尾の「- 媒体名」から取るようにした。
③ 取得できないサイトは、回避せずに止める。
ボット対策で403を返すサイトが1つあった。回避策は探さず、そのソースを無効にした。ルールを破ってまで集めない、というのも設計の一部にしている。
④ Xの読み取りは、投稿とは別の権限がいる。
反応の学習には、投稿後の指標をXから読む必要がある。読み取り権限やプランによっては、401・403・402・429が返る。そのときは、理由を管理画面に表示して一定時間止めるだけにして、投稿や他の機能には影響させないようにしてある。
🛡️ 安全装置
- 📮 Xへの投稿を呼ぶのは、配信ジョブだけ。収集や調査のコードには、投稿処理を書いていない。配信ジョブは初期状態でOFF
- ✋ 承認制で開始。実績(承認数・却下率・警告つきの割合)を見て、問題なければ全自動に切り替える。全自動でも、確度や警告の基準を満たさないものは承認待ちに残る
- ⏳ 最短投稿間隔(30分)・1日の上限(8件)・配信時間帯(7:00〜23:30)・予定から12時間で期限切れ
- 🔐 反応の取得はXの読み取り(GET)だけを行い、投稿用の処理とは別のコードに分けている
- 🧯 提案はすべて「元に戻す」が可能。LLMの暴走が、設定の暴走にならない
🧪 LLMを差し替えてテストする
LLMの出力は毎回変わるので、そのままではテストできない。そこでLLM呼び出し、HTTP取得、Xへの投稿をそれぞれ差し替えられる口を用意し、決定論の部分(検証、提案の承認条件、状態遷移、配信の安全装置)を、固定の入力で確かめている。バックエンドのテストは100件を超える。
初日の誤提案のような「データが少ない状態」のテストも、ここに足した。LLMが何と言っても、コードが通さない——を、テストで固定しておく。
🛠️ 技術構成
| 技術 | 何をしているか |
|---|---|
| 🐘 PHP(レンタルサーバー) | 収集・要約・調査・検証・配信のすべて。管理画面も同じコードベース |
| 🗃️ SQLite | 記事・話題・提案・投稿結果を保存。状態機械の状態もここ |
| 🤖 Anthropic Claude API | 要約も調査も軽量・低コストなClaude Haiku。調査はtool use(ツール呼び出し)のループで、運用エージェントの構造化出力は単一ツールの強制呼び出し |
| 𝕏 X API v2 | 画像つき投稿と、反応(いいね・RTなど)の取得 |
| ⚙️ cron | 収集ジョブ(30分おき)と配信ジョブ(15分おき)を、スケジュール定義に従って起動 |
📊 数字で見ると
- 📰 収集元:11媒体・4地域(US 3/CN 2/TW 3/JP 3)
- 🔧 調査エージェントのツール:4つ(1話題あたり最大6ステップ以上)
- 🧹 運用エージェント:4種(提案は種類・範囲・根拠を検証してから通す)
- ⏱️ 収集の1回の実行:時間予算25秒、30分おきに起動
- 💰 日次のトークン上限:40万
- 📮 配信の上限:1日8件、最短30分間隔、承認制で開始
- 🧪 バックエンドのテスト:100件超
🚀 作ってみて思ったこと
エージェントを作って一番効いたのは、「何をAIに任せ、何を任せないか」の線引きだった。調べる、言い換える、文章にする——ここはLLMが強い。数える、突き合わせる、上限で止める、元に戻す——ここはコードでしか信用できない。AIには自由に考えさせ、その出口に決定論の関所を置くと、安心して任せられる範囲がかなり広がった。
正直に書くと、まだ運用を始めたばかりだ。反応の学習は、確定した投稿が12件以上溜まるまで様子見で、本当に効くのかは、これから数週間のデータを見ないと分からない。ノイズ除外も、実際に要約が進んでノイズ側の件数が溜まるまで、最初の自動追加は出ない。
次は、承認制での実績を見ながら、どこまで全自動にできるかを詰めていく。うまくいった点も、ハマった点も、また書く。